Pytorch中DataLoader的回收机制
环境:Pytorch=2.0.1 Python=3.10
在Pytorch中,DataLoader作为读取数据集的主要工具,可以说是无处不在。其中默认的多进程iterator,_MultiProcessingDataLoaderIter,在设计回收机制时考虑了各种奇奇怪怪的情况,进而变得有些晦涩难懂,对于没有接触过并行或并发编程的人来说(比如我自己),可能更加头疼。本篇博客将以多进程、多线程新手的角度尽可能地解释这些机制,希望能帮助大家进一步地理解Pytorch的DataLoader。
1. Multi-worker DataLoader的工作流程
在dataloader.py [1]中,可以找到关于_MultiProcessingDataLoaderIter的基本工作流程,大致如下图所示(假设worker数量为2):
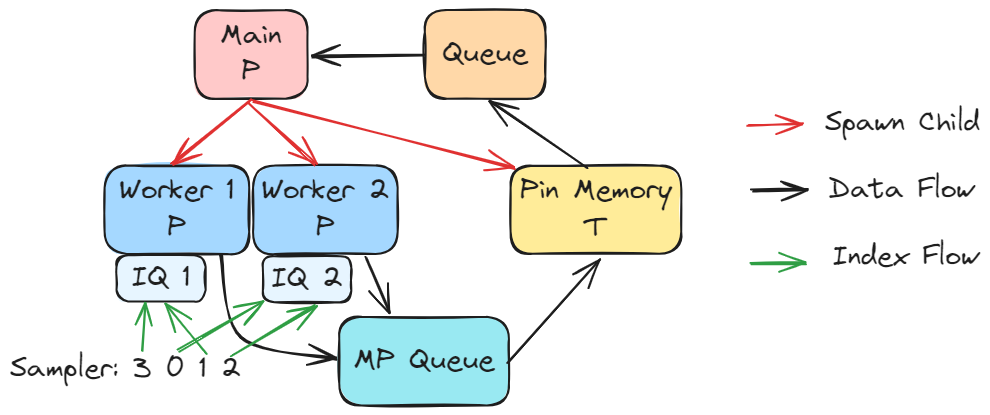
主进程开启两个额外的worker进程和一个pin memory线程。采样器为两个worker进程分配数据的索引,并通过队列将索引传递给worker。拿到索引的worker进程从数据集中读取数据,处理数据,并将处理完成的数据通过torch.multiprocessing.Queue传递给pin memory线程。pin memory线程主要执行Tensor.pin_memory(device)操作,并将处理好的数据通过queue.Queue传递给主进程。
为什么worker用进程,但pin memory用线程?
在Python中,由于GIL(全局解释器锁)的存在,多线程无法实现真正的并行。对于任务繁重的worker来说,如果将其设为线程,将与主线程争抢GIL,令模型推理和数据读取都变得缓慢。因此,worker都以进程的形式存在。Pin memory的过程并不太复杂,时间开销相比于模型推理也不算大,确实可以设置为线程,但为什么不设置为进程,进一步减少与主线程的竞争呢?这大概是考虑了进程间通信的成本问题。worker到pin memory已经存在一层进程间通信,再加上pin memory到主进程的进程间通信,或许会增加不小的开销。设置pin memory为线程的话,传递数据的整体开销会相对小一些。另外,由于进程间通信的底层是os.pipe,可能在进程回收阶段带来一系列问题,所以少一步进程间通信,还能避免不少麻烦的事情,这也是后文要讨论的重点之一。
2. 设计DataLoader的回收机制
对于多个worker的情况,回收的对象就是各个worker进程和pin memory线程。在dataloader.py [1] 中,可以找到_MultiProcessingDataLoaderIter设计者的整体思路。按部就班地翻译一遍似乎没有很大必要,而且我个人水平有限,很难从如此宏观的描述中提炼出有用的信息。所以我想从具体代码出发,分析为什么要这么写,以此来解释回收机制的设计。
利用daemon特性
# dataloader.py L1032. For workers.
w.daemon = True

# dataloader.py L1060. For pin memory thread.
pin_memory_thread.daemon = True
一般认为,daemon进程/线程和一般进程/线程的主要区别在于:主进程结束后,不需要等待daemon进程/线程执行结束,但需要等待一般进程/线程执行结束。用Python伪代码来表示大致如下:
target: Process | Thread

# Now, the main process exits.
if target.daemon:
    target.terminate()
else:
    target.join()
对于DataLoader来说,若主进程结束了,自然没有继续读取数据的必要,所以worker进程和pin memory线程都可以被直接终止。为两者添加daemon特性自然是一个很好的选择,在大部分情况下都可以保证回收的正常进行。然而,稍加深入Python的daemon实现方式,就会发现它存在一个很大的问题:不管是进程还是线程,对应daemon的机制都是通过Python自身实现的,并没有借助底层的操作系统。对于进程来说,daemon机制通过注册atexit回调函数实现:
# multiprocessing/util.py L362.
atexit.register(_exit_function)

# In `_exit_function`, simplified version.
_run_finalizers_pre_daemon()  # Whose priority >= 0.
_handle_daemon()  # Similar to the previous pseudo code.
_run_finalizers_post_daemon()  # Whose priority < 0.
线程的daemon通过threading._shutdown实现,而这个_shutdown函数在Python进程运行的包装函数multiprocessing.process._bootstrap中被调用:
# multiprocessing/process.py L290~336. A simplified version.
def _bootstrap(self):
    try:
        self.run()
    finally:
        util._exit_function()
        threading._shutdown()
考虑到主进程可能由于外部原因(比如SIGKILL)被强制终止,atexit回调函数未必会被执行,进程的回收也就无法保证。线程倒是不太需要担心资源泄漏问题,因为操作系统会兜底,保证线程的资源被回收 [2],[3]。大多数情况下反倒要保证线程不会因为主进程的结束而突然终止,导致某些操作无法执行。在Python中,daemon线程更像是一种默认行为,非daemon情况下,threading._shutdown中通过锁的方式实现类似于join的操作,保证在主进程正常结束时,所有线程都能执行完毕。为了保证worker进程能够在主进程被强制终止时也能正常回收,DataLoader的设计者在worker进程的执行程序中添加了一个针对主进程的观测器,监控主进程的状态。假如发现主进程已经结束,worker进程会立即终止,保证资源的正常回收。
# worker.py L51~59.
class ManagerWatchdog:
    def __init__(self):
        self.manager_pid = os.getppid()
        self.manager_dead = False

    def is_alive(self):
        if not self.manager_dead:
            self.manager_dead = os.getppid() != self.manager_pid
        return not self.manager_dead

# worker.py L208~329.
def _worker_loop(...):
    # Prepare stuffs.
    ...
    watchdog = ManagerWatchdog()
    while watchdog.is_alive():
        # Worker main loop.
        ...
利用Python的垃圾回收机制
若在主进程还未结束时,DataLoader的使命已经完成,那么worker进程和pin memory线程的回收就可以交给Python的垃圾回收机制。
# dataloader.py L1477~1478.
def __del__(self):
    self._shutdown_workers()
_shutdown_workers方法在__del__中被调用,而__del__方法是在_MultiProcessingDataLoaderIter实例被垃圾回收时自动调用的。这保证了在正常的,persistent_workers is False的情况下,下面这种常见的用法可以自然地回收worker进程和pin memory线程:
for data in dataloader:
    # Workers and pin memory thread are created when arrived here.
    process(data)
# The shutdown of workers and pin memory thread will be triggered here.
这个例子中,虽然DataLoader的实例还是完完整整保留着的,但从其__iter__方法:
# Simplied version of dataloader.py L425~438.
def __iter__(self):
    if self.persistent_workers:
        return self._iterator
    else:
        return self._get_iterator()
可以看出,对于persistent_workers is False的情况,DataLoader实例并不会保存iterator的引用,所以当for循环结束时,iterator将自然地被垃圾回收。此外,值得一提的是,如果iterator完成了全部的数据读取任务,将在__del__之前触发_shutdown_workers:
# Simplified dataloader.py L1298~1318.
def _next_data(self):
    while not_finish_data_loading:
        ...
    else:
        if not self.persistent_workers:
            self._shutdown_workers()
        raise StopIteration
那么,_shutdown_workers做了哪些事情呢?
# Simplied version of dataloader.py L1400~1466.
def _shutdown_workers(self):
    # Shutdown pin memory thread.
    self._pin_memory_thread_done_event.set()
    self._mp_queue.put("END")
    self._pin_memory_thread.join()
    self._mp_queue.cancel_join_thread()
    self._mp_queue.close()

    # Shutdown worker processes.
    self._workers_done_event.set()
    for i in range(len(self._workers)):
        self._iq[i].put("END")
    for w in self._workers:
        w.join()
    for q in self._iq:
        q.close()
worker进程 [4] 和pin memory线程 [5] 执行的程序都是无限循环的,所以需要一个特殊的结束标示,例如"END",通知它们结束。对于pin memory线程,正常来说,只要不断读取和worker进程共用的队列_mp_queue,等到结束标志就行。但由于DataLoader传递的数据量在实际应用场景下都较为庞大,等待读取结束会花费不少的时间。所以一个额外的Event对象_pin_memory_thread_done_event被用于快速地通知pin memory线程结束,省去了读取庞大队列所需的时间。对于worker进程来说,索引队列_iq的通信开销小,只需要绕开_mp_queue的写入,就能快速地结束。所以,当worker进程发现事件_workers_done_event被设置时,将跳过读取数据,处理数据等操作,仅进行索引队列的快速读取,直到遇到结束标示。
为什么有个cancel_join_thread? 为了说明这一点,我们需要先了解multiprocessing.Queue的内部实现,大致如下图所示:
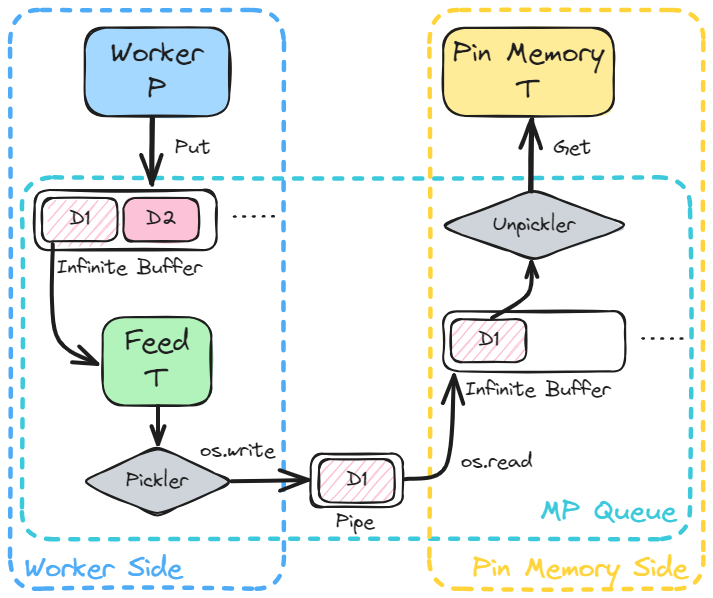
可以看到,所有写入队列的数据都暂时存进了一个无限长的buffer中,一个额外的feed线程负责将数据从buffer中取出,写入到管道os.pipe中。其他进程读取队列时,也是从管道中读取数据。管道通常都有一个容量限制,如果写入的数据过多,且没有及时地读出,将造成管道堵塞或抛出错误(取决于O_NONBLOCK [6]),无法继续写入数据。对于multiprocessing.Queue来说,此时feed线程将卡死在写入管道的操作上,无法终止。如果不设置cancel_join_thread,multiprocessing.Queue默认将注册一个用在_exit_function中的finalizer,等待feed线程结束:
# multiprocessing/queues.py L180~185.
if not self._joincancelled:
    self._jointhread = Finalize(
        self._thread, Queue._finalize_join,
        [weakref.ref(self._thread)],
        exitpriority=-5,
    )

# multiprocessing/queues.py L195~202.
def _finalize_join(twr):
    debug('joining queue thread')
    thread = twr()
    if thread is not None:
        thread.join()
        debug('... queue thread joined')
    else:
        debug('... queue thread already dead')
由此可见,如果feed线程卡死,将导致写入队列的进程无法正常退出。在_shutdown_workers中,pin memory线程作为读取的一方先被关闭了,如果不设置cancel_join_thread,_mp_queue的feed线程有很大概率会卡死,导致worker进程以及主进程,持续地等待feed线程结束,无法正常退出。所以,cancel_join_thread在此对于主进程的正常结束是必不可少的,worker进程在其执行程序的最后也有对应的cancel_join_thread的操作:
# worker.py L327~329.
if done_event.is_set():
    data_queue.cancel_join_thread()
    data_queue.close()
实际上,所有的索引队列在创建时就设置了cancel_join_thread:
# dataloader.py L1024.
index_queue.cancel_join_thread()
为何_mp_queue没有在创建时设置cancel_join_thread? 一般来说,cancel_join_thread之后,读取队列数据的鲁棒性将得不到保证。例如,当worker进程将全部数据移入buffer后,它的使命就完成了,此时feed线程未必能把数据全部送入管道,且另一端读取数据的pin memory线程也未必能够及时地从管道中读取完所有数据。由于worker进程不会等待feed线程结束,而是直接终止,这将导致管道损坏,读取数据的pin memory线程将抛出错误。所以,鲁棒的做法是,当pin memory线程的使命结束时,再设置_mp_queue的cancel_join_thread,保证队列数据的正常读取。对于索引队列_iq来说,当负责写入队列的主进程结束时,worker进程读取数据的鲁棒性已经无关紧要,所以在创建时就可以设置cancel_join_thread。
另外,用于关闭daemon进程的_exit_function中,存在一个等待feed线程结束的finalizer,如果不设置_iq的cancel_join_thread,主进程有可能卡死在_exit_function中,持续地等待feed线程结束,无法正常退出。这么说来,那如果不提前设置_mp_queue的cancel_join_thread,会不会也出现类似的问题呢?
# multiprocessing/queues.py L86~96.
def put(self, obj, ...):
    ...
    if self._thread is None:
        self._start_thread()
    self._buffer.append(obj)
    ...
可以看到,feed线程仅在队列第一次put的时候被创建。由于主进程在_shutdown_workers前,并不会向_mp_queue写入数据,所以不会创建对应的feed线程,也就不需要担心_exit_function中finalizer卡死的问题。虽然如此,在_shutdown_workers中,为了通知pin memory线程结束,主进程需要向_mp_queue写入结束标示,这时feed线程还是被创建了。所以可以看到,在pin memory线程结束后,还是要设置_mp_queue的cancel_join_thread,保证主进程不会卡死。
为何先关闭pin memory线程,再关闭worker进程? 不妨假设先关闭worker进程,再关闭pin memory线程。由之前关于_mp_queue是否设置cancel_join_thread的讨论可知,此时想要直接终止worker进程,就必须设置cancel_join_thread。结果是,worker进程确实可以正常结束,但_mp_queue底层的管道损坏了。此时,pin memory线程还在运行,尝试从损坏的管道中读取数据时会抛出错误。所以,为了保证pin memory线程能够正常结束,必须先关闭pin memory线程,再关闭worker进程。
为何要为pin memory线程和worker进程设置两个独立的结束Event? 假设只有一个独立的结束Event,当Event被设置时,pin memory线程和worker进程同时开始结算。此时,若worker进程结算的速度更快,提前于pin memory线程结束,就可能出现前述的管道损坏问题。所以,为了保证pin memory线程能够先于worker进程结束,必须设置两个独立的结束Event。
worker进程接收结束Event后,能否直接终止? 对于pin memory线程,由于读取数据队列的开销很大,所以为了快速结束,当检测到结束Event时,直接终止。这一般被认为是一种不优雅的结束方式,因为此时_mp_queue的feed线程无法自然地结束,只能等到引用归零后,由Python的垃圾回收机制来终止。我个人认为,worker进程完全也可以用类似的方式,绕过读取_iq的操作,直接终止。但是,由于worker进程读取索引队列的开销相对较小,所以在_worker_loop中,还是选择了优雅的结束方式,将_iq队列消耗完后,再终止。由于_iq队列已经被消耗殆尽,在调用close方法后,feed线程将直接终止,不会卡死在写入管道的操作上。
# multiprocessing/queues.py L284.
_sentinel = object()

# multiprocessing/queues.py L205~209.
def _finalize_close(buffer, ...):
    ...
    # An ending signal.
    buffer.append(_sentinel)
    ...

# multiprocessing/queues.py L212~272.
def _feed(buffer, ...)
    ...
    obj = buffer.popleft()
    if obj is _sentinel:
        # End of the queue.
        ...
        return
    ...
    send_bytes(obj)
    ...
__del__和_exit_function的先后顺序问题。 通常情况下,在Python结束阶段,_MultiProcessingDataLoaderIter实例的__del__方法都可以在_exit_function之前被调用。保证pin memory线程在worker进程之前结束。但特例还真存在:
# dataloader.py L1075~1078.
if self._persistent_workers and self._pin_memory:
    import atexit
    for w in self._workers:
        atexit.register(_MultiProcessingDataLoaderIter._clean_up_worker, w)

# dataloader.py L1470~1475.
def _clean_up_worker(w):
    try:
        w.join(timeout=5.0)
    finally:
        if w.is_alive():
            w.terminate()
这段代码来自于Pytorch pull request #71579 [7],涉及到了一个相对少见的场合,即同时开启persistent_workers和pin_memory的情况。此时,_exit_function有概率先于__del__被调用,导致worker进程提前结束,pin memory线程因管道损坏而抛出错误。这个奇怪的现象可以用下面的代码来复现:
import inspect
from textwrap import dedent

import torch
import torch.utils.data.dataloader as torch_dataloader
from torch.utils.data import DataLoader, IterableDataset


class RandomDataset(IterableDataset):
    def __init__(self, len, size):
        super(RandomDataset).__init__()
        self.len = len
        self.size = size

    def __iter__(self):
        return self

    def __next__(self):
        if self.len <= 0:
            raise StopIteration
        self.len -= 1
        return torch.randn(self.size)


new_init_str = inspect.getsourcelines(torch_dataloader._MultiProcessingDataLoaderIter.__init__)[0]
new_init_str[0] = new_init_str[0].replace("__init__", "__new_init__")
new_init_str[1] = new_init_str[1].replace("super()", "super(_MultiProcessingDataLoaderIter, self)")
del new_init_str[85:89]
new_init_str = dedent("".join(new_init_str))
exec(new_init_str, vars(torch_dataloader), locals())
torch_dataloader._MultiProcessingDataLoaderIter.__init__ = locals()["__new_init__"]


if __name__ == "__main__":
    dl = DataLoader(
        RandomDataset(64, (28, 28)),
        batch_size=16,
        num_workers=2,
        pin_memory=True,
        persistent_workers=True,
    )
    for _ in dl:
        break
    print("Finish")
运行时,有一定概率会出现pin memory线程的报错,也有一定概率能顺利结束,取决于__del__能不能在Python的结束阶段(一个存在许多不确定行为的阶段)先于_exit_function被调用。可以看到,解决这个问题的方法,是额外注册一个atexit回调函数。由于回调函数的调用顺序是最近注册的,最先被调用,所以可以保证_clean_up_worker在_exit_function之前被调用,继而提供了一个5s的空窗,让__del__能够先于_exit_function被调用。说实话,我并不确定我的理解是否正确,因为我完全不了解Python的结束机制,这一块内容涉及到了包括垃圾回收在内的诸多细节,所以大致看看就好。
假设关闭pin_memory,自然没有pin memory线程读取损坏管道的风险。此时,负责从worker进程读取数据的是主进程,但既然都进入Python结束阶段了,主进程不可能会有读取管道的操作,也就不存在上述的问题。如果关闭persistent_workers,由前文中__iter__的实现可知,当for循环结束时,iterator的引用归零,对应的__del__方法将直接被调用,必然先于_exit_function,所以也不会出现这个问题。
处理提前终止的pin memory线程和worker进程
在前一部分中提到,当worker进程提前终止时,pin memory线程读取队列会因为管道损坏问题而抛出异常。另外,当pin memory线程提前终止时,主进程也将无法继续获取数据。所以有必要检测这两种情况,抛出对应的异常,方便用户进行处理。
# dataloader.py L1283~1289.
while self._pin_memory_thread.is_alive():
    # Get the data.
    ...
else:
    raise RuntimeError('Pin memory thread exited unexpectedly')

# dataloader.py L1131~1145. A simplified version.
try:
    # Get the data.
    ...
except Exception as e:
    # When timeout or error.
    failed_workers = []
    for w in enumerate(self._workers):
        if not w.is_alive():
            failed_workers.append(w)
    if len(failed_workers) > 0:
        pids_str = ', '.join(str(w.pid) for w in failed_workers)
        raise RuntimeError(f'DataLoader worker (pid(s) {pids_str}) exited unexpectedly') from e
可以看到,基本的检测思路就是隔一段时间确认一次,如果发现pin memory线程或worker进程提前终止,就抛出异常。此外,DataLoader的设计者还利用了子进程终止时会发送的SIGCHLD信号,提供了一个更快速地检测worker进程提前终止的方法。
# signal_handling.py L63~71.
def handler(signum, frame):
    _error_if_any_worker_fails()
    if previous_handler is not None:
        assert callable(previous_handler)
        previous_handler(signum, frame)

signal.signal(signal.SIGCHLD, handler)
其中,_error_if_any_worker_fails在C++ 中实现 [9],通过waitid来检测worker进程的状态 [8],并依worker进程的状态抛出各种异常(或者无事发生):
error = waitid(P_PID, worker_pid, &infop, WEXITED | WNOHANG | WNOWAIT)
在C++ 层实现的好处在于,不会影响Python层后续对worker进程状态的检测(出于WNOWAIT的效果)。虽然我个人感觉毫无必要,正常使用DataLoader时,谁会主动去检测worker进程的状态?另外,worker进程的信号处理全部在C++ 层实现,以保证Python层信号处理依然完全由用户决定。
Note: Python层的信号处理会在C++ 层的信号处理之后被调用。
Tensor共享内存的回收
在Pytorch的多进程通信中,Tensor是利用共享内存进行传递的 [11],[12],大致的通信机制如下图所示:
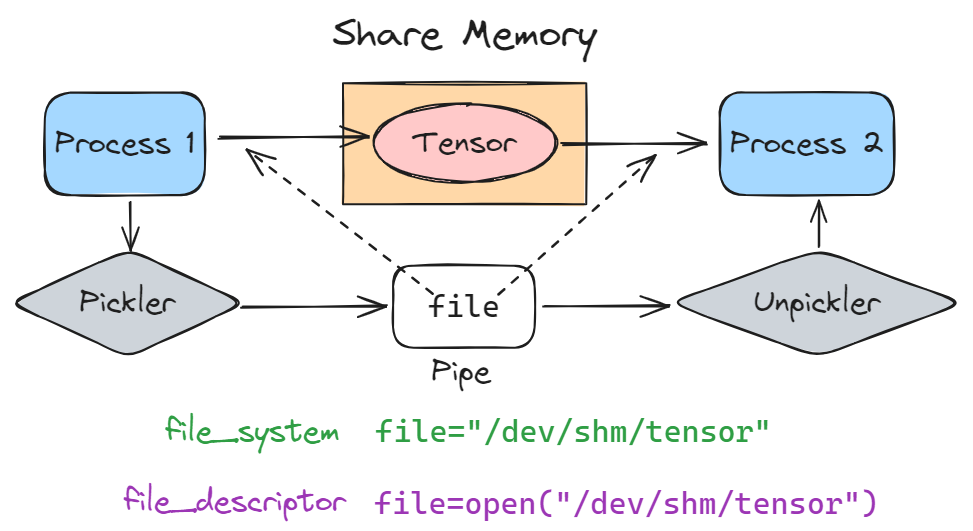
基于不同的torch.multiprocessing._sharing_strategy,进程间传输的内容可以是共享内存对应的文件名(file_system),或者共享内存的文件句柄(file_descriptor)。对于file_system,为了保证创建的临时文件(例如"/dev/shm/tensor")能够最终被删除,Pytorch会开启一个额外的进程,用于回收这些临时文件。对于file_descriptor,Pytorch的做法是在获得文件句柄后马上删除对应的文件,但保留共享内存,这么做自然就不用担心临时文件的回收问题了。默认情况下,Pytorch使用的是file_descriptor共享方式,这就带来了一个问题:由于一个Tensor对应了一个打开的文件,假如同时传递的Tensor数量过多,就会受到打开文件数量上限的限制 [10],导致后续无法进行Tensor的通信。
在_MultiProcessingDataLoaderIter的代码中,可以找到针对这个问题的处理方法:
# dataloader.py L1148~1165:
import tempfile
import errno
try:
    fds_limit_margin = 10
    fs = [tempfile.NamedTemporaryFile() for i in range(fds_limit_margin)]
except OSError as e:
    if e.errno == errno.EMFILE:
        raise RuntimeError(
            "Too many open files. Communication with the"
            " workers is no longer possible. Please increase the"
            " limit using `ulimit -n` in the shell or change the"
            " sharing strategy by calling"
            " `torch.multiprocessing.set_sharing_strategy('file_system')`"
            " at the beginning of your code") from None
当主进程尝试获取数据,但超时或遇到错误时,会检测一下当前打开的文件数量是否触碰到了上限。如果是,就抛出异常,提醒用户调整文件数量上限或者更改共享策略。
3. 总结
对于multi-worker DataLoader来说,worker进程和pin memory线程一方面提升了效率,另一方面也带来了繁琐的回收问题。为了保证回收的高效性和鲁棒性,可以看到Pytorch考虑了诸多细节,令人受益匪浅。但当前的_MultiProcessingDataLoaderIter是否就完美无缺了呢?我感觉未必,当我使用PyCharm进行debug时,偶尔会因为DataLoader内部的某个未知错误导致程序崩溃。截止到目前,Pytorch 2.4.0似乎并没有对dataloader.py做出什么改动,所以这个问题可能还没有得到解决。
Reference
[2]: what_happens_if_the_main_thread_exits_before_all
[3]: kernel-signal-how-a-fatal-signal-kills-a-thread-group
[10]: dataloader.py#L1168-L1263
Comments